Excelテキスト関数ガイド
テキスト関数がデータの万能ツールである理由
現実のデータは乱雑です。名前は「Last, First Middle」として届き、住所は通り、市区町村、都道府県、郵便番号を1つのセルに詰め込み、商品コードは文字位置に意味を埋め込んでいます。テキスト関数は、この混沌からデータをクリーニング、分割、結合し、意味を抽出するツールです。これらがなければ、何千ものセルを手動で編集することになります。これらがあれば、1つの数式を入力して下にドラッグするだけです。
Excelのテキスト関数ライブラリは奥が深いです。このガイドでは、現実のテキスト問題の90%を処理する必須関数を、簡単なものから高度なものまで整理して紹介します。
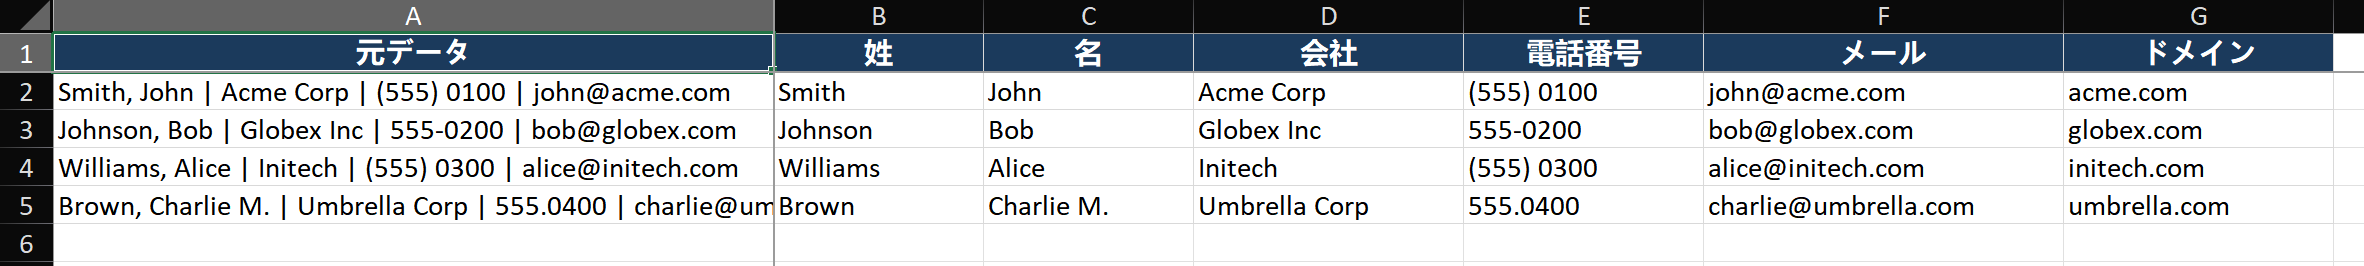
ステップバイステップ:乱雑な連絡先データをクリーニングして再構築する
シナリオ:各セルに「LastName, FirstName | Company | Phone | Email」が1列にすべて入った連絡先リストを受け取ります。Last、First、Company、Phone、Emailの5つのクリーンな列が必要です。
ステップ1 — データのパターンを理解する
- 5〜10個のサンプルセルを確認します。区切り文字が一貫していることを確認します:パイプ記号|がフィールドを区切り、カンマ+スペースが姓と名を区切ります。
- 不規則な点に注意します:「Company Inc.」と「Company, Inc.」のように、会社名のカンマが問題を複雑にする可能性があります。パイプ区切り文字が本当に安全な区切り文字かどうかを確認してください。
ステップ2 — 主要な区切り文字(パイプ)で分割する
- データの右側に5列を挿入します。Last、First、Company、Phone、Emailというラベルを付けます。
- より簡単な方法 — 区切り位置:データ列を選択します。データ>区切り位置>カンマやタブなどの区切り文字>その他をチェックして|と入力します。完了をクリックします。Excelが5列に分割します。
- または、動的分割に数式を使用します:
- Company (C2): =TRIM(MID(SUBSTITUTE($A2,"|",REPT(" ",100)), 100, 100))
- このSUBSTITUTE+REPTのテクニックは、各区切り文字を100個のスペースに置き換え、MIDが各セグメントを抽出します。TRIMが余分なスペースを削除します。
- 2番目のセグメントには,100,100を,200,100に変更します。3番目には,300,100を使用します。以下同様です。
ステップ3 — 名前フィールドを姓と名に分割する
- Last Name: =LEFT(B2, FIND(",", B2)-1) — カンマより前のすべて。
- First Name: =TRIM(RIGHT(B2, LEN(B2)-FIND(",", B2)-1)) — カンマより後のすべて。TRIMで先頭のスペースを削除します。
- データにミドルネームがある場合、カンマより後のすべてを取得するため、適切に処理されます。
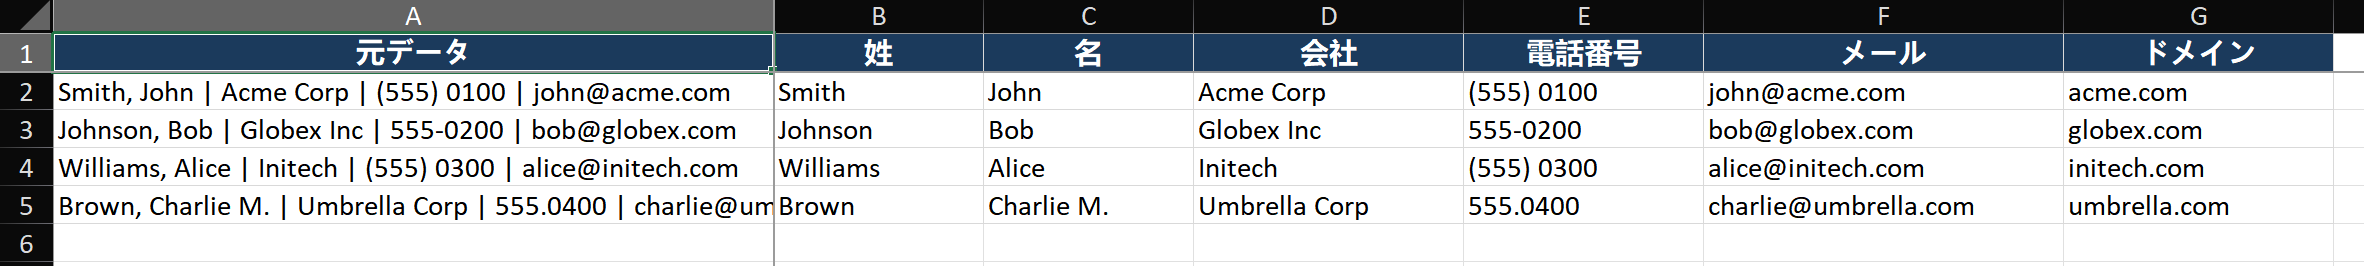
ステップ4 — 電話番号をクリーニングする
- 抽出された電話番号は「 555-0100 」(余分なスペース)や「(555) 0100」(混合形式)のように見えるかもしれません。
- 数字以外の文字を除去(Excel 365): =TEXTJOIN("", TRUE, IF(ISNUMBER(--MID(D2, SEQUENCE(LEN(D2)), 1)), MID(D2, SEQUENCE(LEN(D2)), 1), ""))
- 古いExcelでは、ネストしたSUBSTITUTEを使用します:=SUBSTITUTE(SUBSTITUTE(SUBSTITUTE(SUBSTITUTE(TRIM(D2),"(",""),")",""),"-","")," ","")
- (XXX) XXX-XXXX形式に再フォーマット:=TEXT(CLEAN_PHONE,"(000) 000-0000")、ここでCLEAN_PHONEは上記の結果です。
主要テクニック
- TEXTJOIN for combining:
=TEXTJOIN(", ", TRUE, B2:B10)joins values with a delimiter and skips empty cells (TRUE argument). Much cleaner than=A2&", "&B2&", "&C2. - TEXT for number formatting in strings:
="Revenue: " & TEXT(B2, "¥#,##0.00")preserves formatting when combining numbers with text. Without TEXT, the number loses its format. - SUBSTITUTEで対象を絞った置換:=SUBSTITUTE(A2, "Old", "New")はすべての出現を置換します。第4引数を追加してn番目の出現のみを置換:=SUBSTITUTE(A2, "-", "|", 2)は2番目のハイフンのみを置換します。
- LEN for validation:
=IF(LEN(B2)<>10, "Invalid Phone", "OK")catches incorrectly formatted phone numbers instantly.
よくあるミス
- テキストが存在しない可能性がある場合にIFERRORなしでFINDを使用する。=FIND("@", A2)は@がない場合#VALUE!を返します。IFERRORでラップします:=IFERROR(FIND("@", A2), 0)。
- FINDが1からカウントを開始することを忘れている。位置0のMIDはエラーになります。必要に応じて1を引いて位置1以上に保ちます。
- TRIMはASCIIスペース(文字コード32)のみを削除します。Webデータにはノーブレークスペース(文字コード160)がよく含まれます。TRIMの前に=SUBSTITUTE(A2, CHAR(160), " ")を使用してください。
- PROPERの大文字化エラー。「MCDONALD」が「Mcdonald」に、「USA」が「Usa」になります。固有名詞には手動での修正またはカスタム参照テーブルが必要です。
上級者向けヒント
- N番目の単語を抽出:=TRIM(MID(SUBSTITUTE(A2, " ", REPT(" ", LEN(A2))), (N-1)*LEN(A2)+1, LEN(A2)))。N=1で最初の単語、N=2で2番目、以下同様です。
- TEXTSPLIT (Excel 365): =TEXTSPLIT(A2, "|")は、区切られた文字列を列全体に動的に分割します。TEXTJOINと組み合わせることで、補助列なしで強力な再構成が可能です。
- REPTでセル内ビジュアルインジケーター:=REPT("|", B2/10)はセル内に棒グラフを作成します。条件付き書式のフォント色と組み合わせることで、グラフオブジェクトなしで即座に視覚的な比較ができます。