엑셀 텍스트 함수 완벽 가이드
텍스트 함수가 데이터 작업의 만능 도구인 이유
실제 데이터는 지저분합니다. 이름은 "성, 이름 중간이름" 형식으로 도착하고, 주소는 거리, 도시, 주, 우편번호가 하나의 셀에 몰려 있으며, 제품 코드는 문자 위치에 의미를 담고 있습니다. 텍스트 함수는 이러한 혼란에서 데이터를 정리하고, 분할하고, 결합하고, 의미를 추출하는 도구입니다. 이 함수들이 없으면 수천 개의 셀을 수동으로 편집해야 합니다. 함수를 사용하면 하나의 수식을 작성하여 아래로 드래그하기만 하면 됩니다.
엑셀의 텍스트 함수 라이브러리는 매우 깊습니다. 이 가이드에서는 실제 텍스트 문제의 90%를 처리하는 핵심 함수들을 단순한 것부터 고급까지 체계적으로 다룹니다.
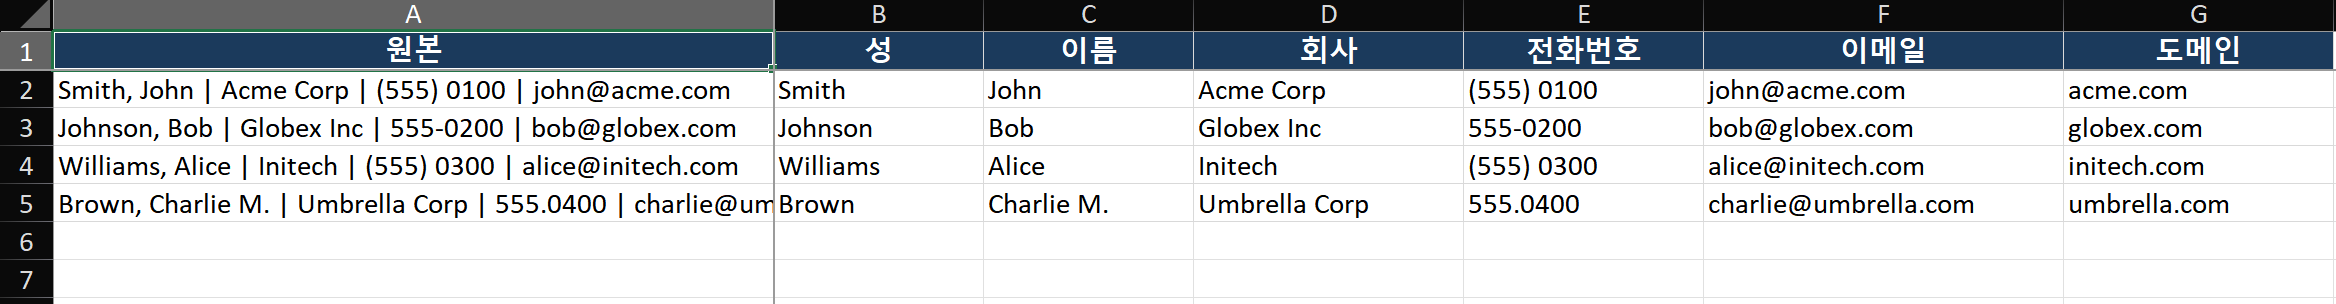
단계별 가이드: 지저분한 연락처 데이터 정리 및 구조화
시나리오: 각 셀에 "성, 이름 | 회사 | 전화번호 | 이메일"이 하나의 열에 모두 들어 있는 연락처 목록을 받았습니다. 성, 이름, 회사, 전화번호, 이메일의 5개 깔끔한 열이 필요합니다.
1단계 — 데이터 패턴 이해하기
- 5-10개의 샘플 셀을 확인하세요. 구분 기호가 일관적인지 확인합니다: 파이프 기호
|가 필드를 구분하고, 쉼표-공백이 성과 이름을 구분합니다. - 불규칙한 부분을 메모하세요: 일부 항목은 "Company Inc." 대 "Company, Inc."를 사용할 수 있습니다. 회사 이름의 쉼표가 문제를 복잡하게 만들 수 있습니다. 파이프 구분 기호가 진정으로 안전한 구분자인지 확인하세요.
2단계 — 기본 구분 기호(파이프)로 분할하기
- 데이터 오른쪽에 5개의 열을 삽입하세요. 각 열의 제목을 성, 이름, 회사, 전화번호, 이메일로 지정합니다.
- 더 간단한 방법 — 텍스트 나누기: 데이터 열을 선택하세요. 데이터 > 텍스트 나누기 > 구분 기호로 분리됨 > 기타를 선택하고
|를 입력합니다. 마침을 클릭하면 엑셀이 5개 열로 분할합니다. - 또는 동적 분할을 위한 수식 사용:
- 회사 (C2):
=TRIM(MID(SUBSTITUTE($A2,"|",REPT(" ",100)), 100, 100)) - 이 SUBSTITUTE+REPT 기법은 각 구분 기호를 100개의 공백으로 대체한 다음, MID가 각 세그먼트를 추출합니다. TRIM이 추가 공백을 제거합니다.
- 두 번째 세그먼트는
,100,100을,200,100으로, 세 번째는,300,100으로 변경하는 식입니다.
3단계 — 이름 필드를 성과 이름으로 분할하기
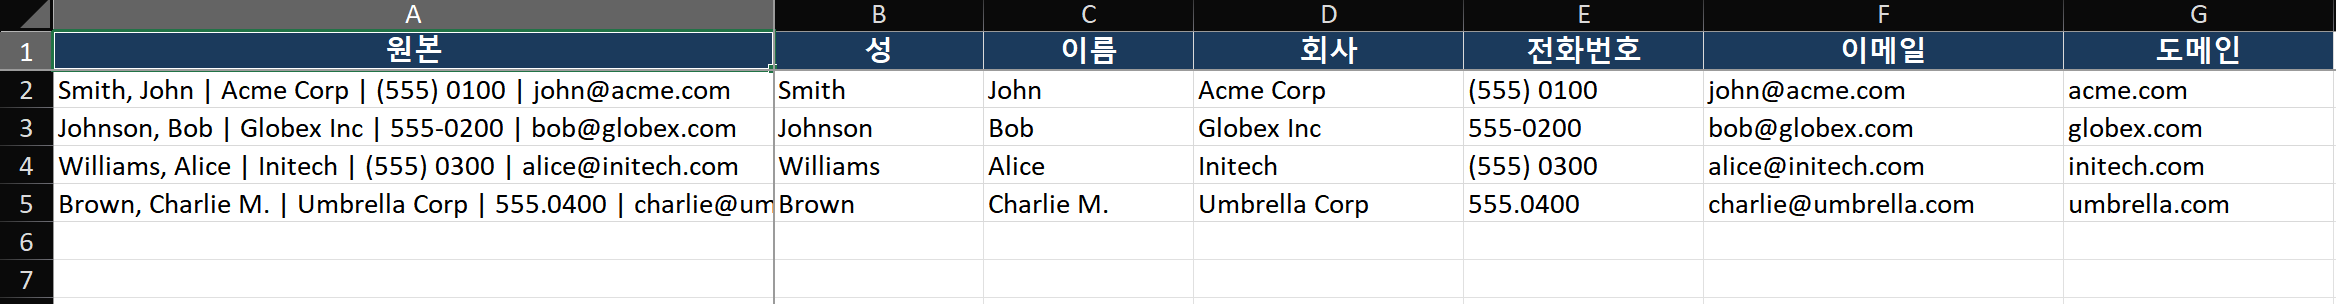
- 성:
=LEFT(B2, FIND(",", B2)-1)— 쉼표 앞의 모든 내용. - 이름:
=TRIM(RIGHT(B2, LEN(B2)-FIND(",", B2)-1))— 쉼표 뒤의 모든 내용, TRIM으로 앞의 공백을 제거합니다. - 데이터에 중간 이름이 있는 경우, 쉼표 뒤의 모든 내용을 가져오므로 중간 이름도 자연스럽게 처리됩니다.
4단계 — 전화번호 정리하기
- 추출된 전화번호가 " 555-0100 "(추가 공백) 또는 "(555) 0100"(혼합 형식)처럼 보일 수 있습니다.
- 숫자가 아닌 문자 제거하기 (Excel 365):
=TEXTJOIN("", TRUE, IF(ISNUMBER(--MID(D2, SEQUENCE(LEN(D2)), 1)), MID(D2, SEQUENCE(LEN(D2)), 1), "")) - 구버전 엑셀의 경우 중첩 SUBSTITUTE 사용:
=SUBSTITUTE(SUBSTITUTE(SUBSTITUTE(SUBSTITUTE(TRIM(D2),"(",""),")",""),"-","")," ","") - (XXX) XXX-XXXX 형식으로 다시 지정:
=TEXT(CLEAN_PHONE,"(000) 000-0000"), 여기서 CLEAN_PHONE은 위의 결과입니다.
핵심 테크닉
- 결합을 위한 TEXTJOIN:
=TEXTJOIN(", ", TRUE, B2:B10)은 구분 기호로 값을 결합하고 빈 셀을 건너뜁니다(TRUE 인수).=A2&", "&B2&", "&C2보다 훨씬 깔끔합니다. - 문자열 내 숫자 서식을 위한 TEXT:
="매출: " & TEXT(B2, "¥#,##0.00")은 숫자와 텍스트를 결합할 때 서식을 유지합니다. TEXT가 없으면 숫자의 서식이 손실됩니다. - 대상 지정 치환을 위한 SUBSTITUTE:
=SUBSTITUTE(A2, "Old", "New")는 모든 발생을 치환합니다. 네 번째 인수를 추가하여 n번째 발생만 치환합니다:=SUBSTITUTE(A2, "-", "|", 2)는 두 번째 하이픈만 치환합니다. - 유효성 검사를 위한 LEN:
=IF(LEN(B2)<>10, "잘못된 전화번호", "OK")는 잘못된 형식의 전화번호를 즉시 감지합니다.
흔한 실수
- 텍스트가 없을 수 있을 때 IFERROR 없이 FIND 사용.
=FIND("@", A2)는 @가 없으면 #VALUE!를 반환합니다. IFERROR로 감싸세요:=IFERROR(FIND("@", A2), 0). - FIND가 1부터 세기 시작한다는 것을 잊음. 위치 0으로 MID를 사용하면 오류가 발생합니다. 필요시 1을 빼서 위치 1 이상을 유지하세요.
- TRIM은 ASCII 공백(char 32)만 제거합니다. 웹 데이터에는 줄 바꿈 없는 공백(char 160)이 자주 포함됩니다. TRIM 전에
=SUBSTITUTE(A2, CHAR(160), " ")을 사용하세요. - PROPER 대문자화 오류. "MCDONALD"는 "Mcdonald"가 되고, "USA"는 "Usa"가 됩니다. 고유 명사에 대해서는 수동 수정 또는 사용자 정의 조회 테이블이 필요합니다.
고급 팁
- N번째 단어 추출:
=TRIM(MID(SUBSTITUTE(A2, " ", REPT(" ", LEN(A2))), (N-1)*LEN(A2)+1, LEN(A2))). N=1은 첫 번째 단어, N=2는 두 번째 단어 등입니다. - TEXTSPLIT (Excel 365):
=TEXTSPLIT(A2, "|")는 구분된 문자열을 열에 걸쳐 동적으로 분할합니다. TEXTJOIN과 결합하면 보조 열 없이 강력한 재구성이 가능합니다. - 셀 내 시각적 표시를 위한 REPT:
=REPT("|", B2/10)은 셀 안에 막대 차트를 만듭니다. 조건부 서식 글꼴 색상과 결합하면 차트 개체 없이 즉각적인 시각적 비교가 가능합니다.